RAG系统怎么进行评测?
作者:程序员马丁
Ragent AI —— 从 0 到 1 纯手工打造企业级 Agentic RAG,拒绝 Demo 玩具!AI 时代,助你拿个offer。
开篇引言
前面 18 篇,咱们一步步把 RAG 链路跑通了——从分块、向量化、检索策略到生成策略,从 Function Call、MCP 到会话记忆、Query 改写、意图识别,最后还讲了评估与优化的基本思路。到这里,一套 RAG 系统已经能跑起来、能回答用户问题了。
Ragent 的测评项目地址 ragenteval,放在了咱们星球内部的代码仓库,如果之前申请过牛券、oneThread 等项目,无需重复申请。如果还没有申请过,请参考 内部项目权限申请流程 进行申请,审核开放后即可查看。
但跑通只是起点。
你改了一行 system prompt,检索效果到底是变好还是变差?你换了 embedding 模型,答案质量有没有提升?你加了 rerank,有没有引入回归?这些问题,靠抽几条 case 看看效果是回答不了的。
评测系列就是来解决这个问题的。前 18 篇回答的是问答链路怎么跑通,接下来这 11 篇回答一个完全不同的问题——跑通之后,怎么证明它跑得好?
之前的并发项目,比如 12306、牛券这些,如何让面试官感觉是有亮点的?重点考量的是项目的并发、数据以及架构设计,对于现在的 AI 智能体项目,更多是测评、真实业务场景得出来的指标。
不评的代价:三个场景
在讲评测体系之前,先看三个场景,都是项目里经常踩的坑。
场景一:改 chunk size,抽查还行,上线就崩。 你把 chunk size 从 512 改到 1024,抽了 10 个常见问题跑了一下,检索结果看着还行,于是上线了。过了两天,客服反馈售后类问题全崩了——退货政策和退款流程原本在相邻段落,改大 chunk 之后被合进同一个 chunk,但保修条款那段被截断了。这类问题在你抽查的 10 个里恰好没有覆盖到。
场景二:换 embedding 模型,几条 case 验证就上线。 同事推荐了一个新的 embedding 模型,你换上去跑了几个典型问题,效果确实好——语义理解更准了。结果过了两周,产品经理说有用户投诉,一查发现包含英文型号名的问题(iPhone 16 Pro Max、AirPods Pro 2)检索效果全面退化。新模型中文语义能力强,但对中英混合场景的处理不如旧模型。
场景三:改 prompt 减幻觉,但兜底率飙了。 你在 system prompt 里加了一条“如果上下文中没有明确提到的信息,不要回答,请告知用户无法回答”。幻觉确实少了,但兜底率从 5% 飙到 30%——很多检索到了相关 chunk、本该正常回答的问题,模型也开始说“找不到相关信息”了。约束太强,误杀了一大片正常场景。
三个场景,同一个问题:没有评测体系,每次改动都是在赌没问题。你不知道改好了什么,也不知道改坏了什么。
评估与优化那篇讲过基本思路——分层评估、Hit Rate、MRR、LLM-as-Judge。但那篇是讲概念的,从这篇开始,咱们讲的是一个已经跑通的、完整的评测项目——有评估集、有 runner、有指标、有报告。不是规划将来打算怎么做,而是讲实际怎么做、为什么这么做、踩了哪些坑。
评测的全景图:从评估集到报告
1. 两个仓库各管什么
评测体系涉及两个独立的仓库:
| 仓库 | 角色 | 语言 | 关键产物 |
|---|---|---|---|
ragent | 被评系统 | Java 17 + Spring Boot | /rag/v3/chat(SSE 流式接口)、/rag/eval(JSON 评测旁路接口) |
ragenteval | 评测项目 | Python 3.11 | 评估集、runner、指标脚本、报告 |
为什么要分成两个仓库?三个理由:
- 评测逻辑不应该侵入生产代码。:评测需要的字段(标准答案、期望文档 ID、难度分级)跟生产接口完全无关,混在一起会让代码难以维护。
- Python 生态更适合做评测: RAGAS 是 Python 库,数据处理用 pandas 更方便,评测脚本不需要 Spring Boot 那套重框架。
- 两个仓库独立迭代互不影响:改了评估集不用重新部署被评系统,改了被评系统的检索逻辑也不用动评测代码。
2. 四段流程:init → run → score → report
整个评测从头到尾分四段,每段有明确的输入和产出。用一张图来看数据是怎么流的:
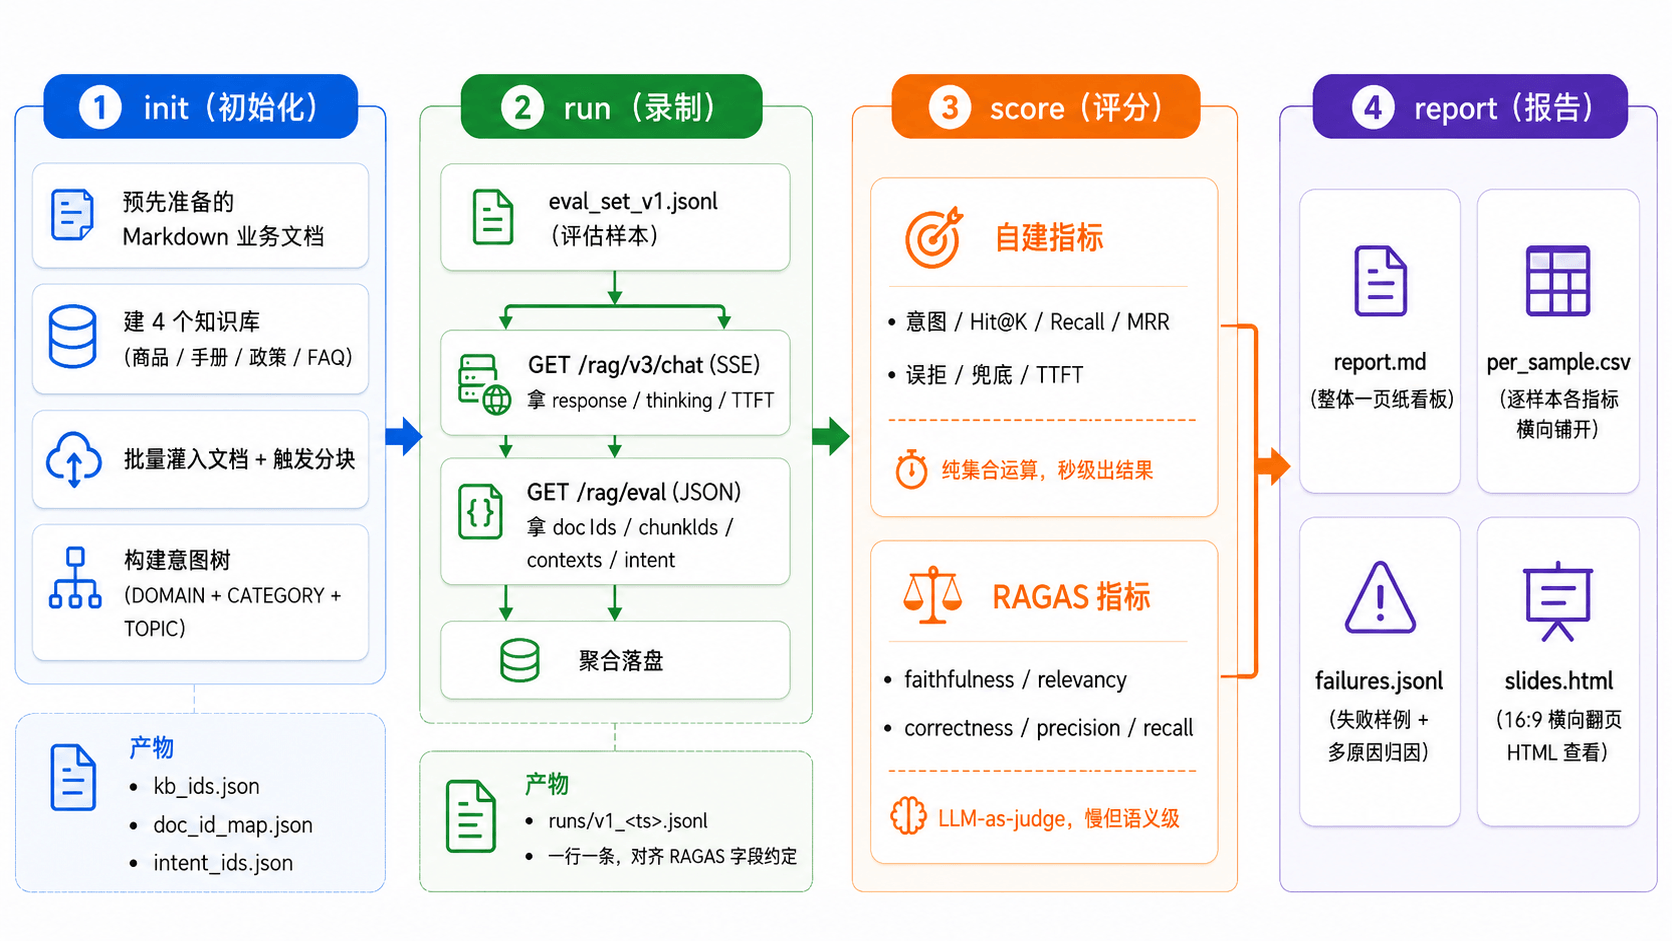
逐段拆开看:
init(初始化)——把被评系统搭到可评测的状态。在 ragent 里建 4 个知识库(商品库、使用手册库、政策库、FAQ 库),批量灌入 115 篇 Markdown 文档并触发分块,再构建一棵多叶子节点的意图树。跑一次就行,后面除非换数据否则不用重跑。
run(录制)——把 150 条评估样本逐条喂进 ragent,每条调两个接口:SSE 接口拿真实链路的 response 和首字耗时,JSON 旁路接口拿检索证据。结果聚合成一份 runs/v1_<ts>.jsonl,一行一条样本。
这里有一个核心设计:录制一次,评分 N 次。runner 跑一次成本最高——要真实调接口、等 LLM 生成,150 条串行跑下来要几十分钟。但录好之后,score 阶段基于本地文件反复跑,自建指标秒级出结果。改了评分逻辑、加了新指标,都不需要重新录制。
score(评分)——基于录制结果算指标。自建指标是纯集合运算,秒级出结果。RAGAS 指标要调 LLM 做 judge,慢但能评语义层面的东西。两套一起跑,互不依赖。
report(报告)——把指标结果整理成人能看的产物。给研发看的 markdown 和 CSV,给人工 review 的失败样例 JSONL。
3. 被评系统的两个接口
ragent 为评测暴露了两个接口,各有分工:
| 接口 | 方式 | 拿什么 | 为什么需要 |
|---|---|---|---|
/rag/v3/chat | SSE 流式 | response、thinking、TTFT、整流耗时 | 走真实生产链路,拿到用户实际会看到的答案和性能数据 |
/rag/eval | JSON 同步 | docIds、chunkIds、contexts、intentLeafIds | 纯检索旁路,跳过 LLM 生成,直接拿检索证据用于算命中率等指标 |
为什么不能只用一个接口?/rag/v3/chat 是真实生产链路,拿得到 response 和 TTFT,但 SSE 流里不含检索中间产物(召回了哪些文档、命中了哪些意图),这些数据算 Hit@K、Recall@K 必须有。/rag/eval 专门返回检索证据,但它只跑检索不跑 LLM,拿不到最终答案。两个接口配合,才能把答案 + 证据 + 性能数据一次性收齐。
评测旁路通过 app.eval.enabled=true 配置开关控制,生产环境关闭后 EvalController 不注册,零开销。
这个设计有一个已知的妥协:两次请求是两次独立检索,召回结果不保证完全一致(受随机性、缓存、改写抖动影响),但实践上足够接近,基本上不会出现问题。
或者,可以在面试中说改造了已有接口,在开启测评情况下收集数据请求落库,通过 TraceID 串联也可以。这种也是我刚开始的做法,但是看到改动的代码有点多,为了一些测评逻辑担心影响大家学习的进度,就改成了独立测评接口。
两套指标:自建 + RAGAS
1. 为什么需要两套
一套不够吗?真不够。
自建指标能算的事情:文档命中没命中、命中排在第几、意图分类对不对、首字到达要多久——这些全是集合运算或数值统计,结果确定、没有方差、秒级出结果,每次提交代码都能跑一遍。
但自建指标算不了一件很关键的事:内容对不对。比如,检索确实命中了正确的文档,Hit@5 = 1.0,指标绿灯全亮。但模型看着这些 chunk,编了一段 chunk 里根本没有的信息——自建指标看不出来,因为它不看答案内容,只看命中了没有。
这就需要 RAGAS 的 LLM-as-judge:让另一个大模型当裁判,把 response 拆成一条条 claim,逐个判断每条 claim 是否能从检索到的 chunk 中推导出来。这是语义层面的评判,不是集合运算能搞定的。
反过来,RAGAS 也有覆盖不了的地方。它完全不管意图分类对不对(意图错了后面全错,这是最上游的闸门),也不管首字耗时多少(用户等了 8 秒才看到第一个字,体验很差,但 RAGAS 不评性能)。
所以两套互补,缺一不可。
2. 自建指标一览
| 指标 | 一句话定义 | 仅统计 |
|---|---|---|
| 意图 Top-1 准确率 | 预测的意图和标注的意图是否一致 | 全量 |
| Hit@K(K=1/3/5/10) | Top-K 召回文档里有没有至少一个相关文档 | requires_rag=true 且有期望文档 |
| Recall@K | Top-K 里命中了多少比例的期望文档 | 同上 |
| MRR@10 | 第一个命中文档排在第几位(排名的倒数) | 同上 |
| 误拒率 | 应该走 RAG 检索但没有返回任何文档 | requires_rag=true |
| 答案兜底率 | 应该回答但 response 却是兜底话术 | 同上 |
| 错答率(过召回) | 不该走 RAG 却走了 RAG 检索 | requires_rag=false |
| 首字平均延迟/回答延迟 | 答案返回首字时间和全部回答完的时间 | 全量 |
这些指标的具体算法和口径选择在第 5 篇(意图 + 检索指标)和第 6 篇(性能指标)详细展开。这里只需要知道有哪些、各自看什么就够了。
3. RAGAS 指标一览
| 指标 | 一句话定义 | 评估层 |
|---|---|---|
faithfulness | 答案是否忠实于召回的 chunk,有没有编造 | 生成层 |
answer_relevancy | 答案是否切题,有没有答非所问 | 生成层 |
answer_correctness | 答案跟标准答案比,事实对不对 | 生成层 |
context_precision | 召回的 chunk 里有用信息的比例高不高 | 检索层 |
context_recall | 标准答案需要的信息是否被召回覆盖 | 检索层 |
RAGAS 的三个特点要提前知道:全靠 LLM-as-judge 评分(贵、慢);单次跑有 3%~5% 方差(不能只跑一次就下结论);中文场景偶发 NaN(默认 prompt 拆 claim 时大模型偶尔返回非 JSON)。
RAGAS 的指标远远不止这些,但是从咱们关注的模型回复评测角度,这五个是比较好的。
4. 两套指标的协同
| 维度 | 自建指标 | RAGAS 指标 |
|---|---|---|
| 出结果速度 | 秒级 | 150 条约 10~20 分钟 |
| 评估维度 | 命中 / 排序 / 意图 / 性能 / 行为 | 忠实度 / 切题度 / 正确性 / 召回精度和覆盖 |
| 有无方差 | 无,纯确定性运算 | 有,单次 3%~5%,需多轮取均值 |
| CI 适合度 | 每次提交都跑 | 太慢太贵,只在改版前后对比跑 |
| 成本 | 零(纯本地运算) | 每条 5 指标 ≈ 15 次 LLM judge 调用(一般一个指标调用3次模型取平均值) |
| 能评语义吗 | 不能 | 能 |
协同策略:自建当 CI 闸门,RAGAS 当离线深度评估。
每次提交代码,CI 自动跑自建指标,Hit@5 掉了不让合入。改版前后(换模型、改 prompt、调检索策略),手动跑一次 RAGAS,看语义层面有没有退化。两套配合,粗筛 + 精检,既不拖慢开发节奏,也不漏掉语义级的问题。
一页纸看板
指标那么多,看哪些?用一张表收束,这是评测报告的核心看板:
| 维度 | 指标 | 来源 | 参考目标 |
|---|---|---|---|
| 意图 | Top-1 准确率 | 自建 | >= 92% |
| 检索 | Doc Hit@5 | 自建 | >= 90% |
| 检索 | Recall@5 (must) | 自建 | -- |
| 检索 | context_recall | RAGAS | >= 0.80 |
| 检索 | context_precision | RAGAS | >= 0.75 |
| 生成 | faithfulness | RAGAS | >= 0.90 |
| 生成 | answer_correctness | RAGAS | >= 0.80 |
| 生成 | answer_relevancy | RAGAS | >= 0.85 |
| 行为 | 误拒率 | 自建 | <= 3% |
| 行为 | 错答率(过召回) | 自建 | <= 3% |
| 性能 | 首字 P95(TTFT) | 自建 | <= 6~7s |
这些阈值是起步参考,第一次 baseline 跑完后应该回头校准。所有指标都可以按二级意图切片——按 22 个意图叶子分组看,找最差的 3 个场景定向优化,比盯整体均值有用得多。
评测系列的阅读路径
这个系列一共 11 篇,按主题分成五组。完整结构速览:
RAG 评测系列
 │
 ├─ 1.  全景图:两仓库 × 四流程 × 两套指标             ← 地图(本篇)
 │
 ├─ 2.  评估集 schema 与 150 条分布                    ┐ 评估集
 ├─ 3.  KB / 文档 / 意图树初始化                       ┘ 与初始化
 │
 ├─ 4.  评测旁路接口 + SSE 聚合 + TTFT 打点            ← Runner 链路
 │
 ├─ 5.  意图准确率 + Hit@K / Recall@K / MRR            ┐ 自建指标
 ├─ 6.  响应时间看首字而非整流                           ┘
 │
 ├─ 7.  RAGAS 是什么 + 为什么选这 5 个                 ┐
 ├─ 8.  装 Python + RAGAS + 跑通第一个分数             ├ RAGAS
 ├─ 9.  5 个指标全解读(算法 + 配对读法)                ┘
 │
 ├─ 10. RAGAS 的四个坑                                 ┐ 落地
 └─ 11. 报告 + 看板 + 失败归因                          ┘
小结与下一篇预告
这篇画了一张评测的全景地图:
- 两个仓库:ragent 是被评系统,ragenteval 是评测项目,各管各的,互不侵入
- 四段流程:init 建库灌文档 → run 录制数据 → score 算两套指标 → report 出报告
- 两套指标:自建指标秒级出结果当 CI 闸门,RAGAS 指标语义级评判当离线深度评估,两套配合才完整
地图画完了,接下来一篇一篇讲细节。下一篇从地基开始——评估集。150 条评估样本是怎么设计的?query_id、intent_l2、expected_doc_ids、ground_truth 这些字段各自为什么存在、会被哪个指标消费、缺失了会怎样?