Ragent2.0项目启动与数据初始化
前两篇把Agent的基本概念讲清楚了,这一篇先把Ragent2.0跑起来。
整体启动方式和1.0差不多,主要多了数据库重建、比特严选数据初始化和MCP Server。Elasticsearch、LightRAG、LangFuse都是可选项,用到对应能力时再启动。
有一条启动顺序需要提前记住:MCP Server必须先于RagentApplication启动。主服务只会在启动阶段发现并注册MCP工具,顺序反了就要重启主服务。后续文章默认都使用这里初始化好的环境和数据。
模型服务切换至DeepSeek
DeepSeek随着26年9月份发布deepseek-flash模型后,对于Agent对话有着不错的增强,咱们v2架构的Agent对话使用该模型。
2.0架构下,百炼平台没有变化,把之前轨迹流动的向量模型切换了过来。再然后就是新增加了DeepSeek。
步骤1:注册并登录
访问DeepSeek开放平台官网:https://platform.deepseek.com
步骤2:创建并复制API Key
登录后,进入 「API Keys」 管理页面,点击 「创建API Key」,输入密钥名称(如ragent),创建成功后点击 「复制」 按钮保存API Key。
如果仅用于本地开发测试,可以直接将API Key写入application.yaml配置文件中:
ai:
  providers:
    bailian:
      api-key: sk-xxxxxxxxxxxxx  # 替换为你的阿里云百炼 API Key
    deepseek:
      api-key: sk-xxxxxxxxxxxxx  # 替换为你的DeepSeek API Key
⚠️ 安全提示: 直接将密钥写入配置文件存在泄露风险,请勿将包含真实密钥的配置文件提交到Git仓库。如果需要提交Git仓库,可以选择通过环境变量注入方式。
多出来的服务,不用一次全开
1. 先看结论
1.0已经用到的PostgreSQL、Redis、RocketMQ、对象存储等基础服务,仍按原来的方式准备。
2.0分支里比较显眼的新面孔是Elasticsearch、LightRAG和LangFuse。它们各管一件事,也各有独立开关。
| 服务 | 解决什么问题 | 默认是否启用 | 什么时候才需要启动 | 仓库内位置 |
|---|---|---|---|---|
| Elasticsearch | BM25关键词召回,补向量检索对编号、专有名词和精确词不敏感的问题 | 否 | 打开关键词检索通道时 | resources/docker/elasticsearch-8.17.sh |
| Neo4j + LightRAG | 构建知识图谱,提供图谱可视化与多跳关系召回 | 否 | 打开图谱后端时 | resources/docker/graphrag/ |
| LangFuse | 查看Agent每一轮模型输入、工具调用、耗时与Token | 否 | 排查或分析Agent链路时 | resources/docker/langfuse/ |
默认配置已经把这些能力关掉:rag.keyword.type=none、rag.graph.type=none、agent.trace.enabled=false。不启动对应服务,主链路照常使用向量检索和Agent能力。
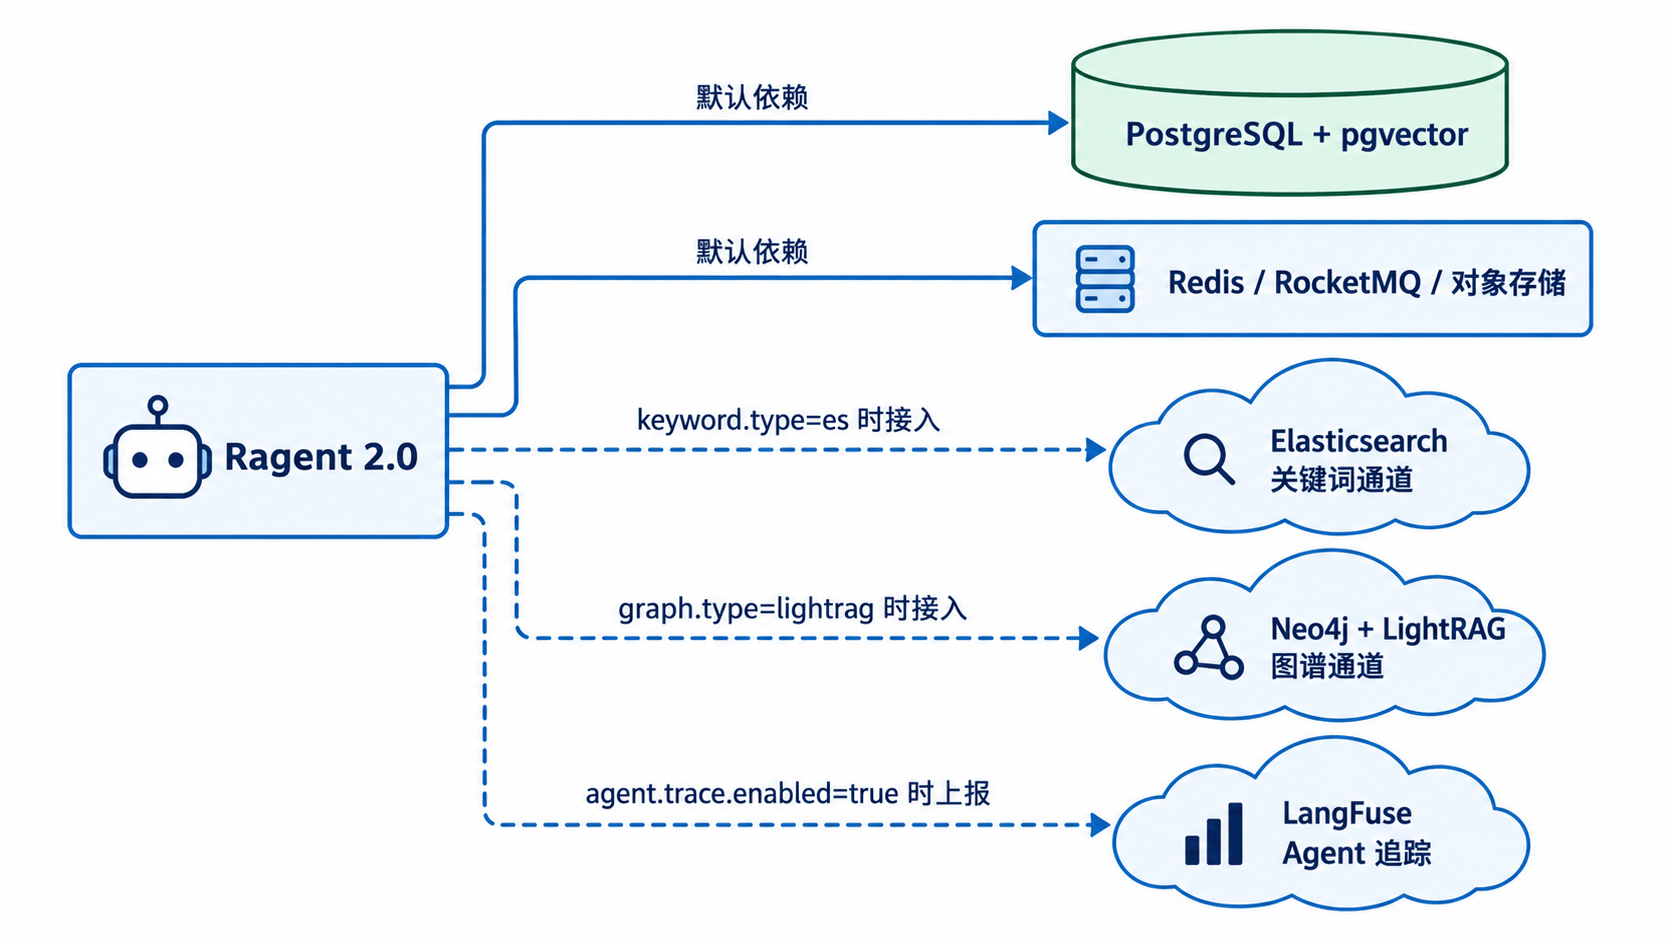
把三套可选服务全开当然也能跑,代价是本机资源占用、启动时间和排障面都会扩大。尤其LangFuse的本地编排包含Web、Worker、ClickHouse、PostgreSQL、Redis、MinIO六个容器,只为了先把项目跑起来,没必要背上这组开销。
如果大家想学习2.0的Agent架构,上面三个都不是必须。我建议可以跳过直接看下个章节,除非你的本地电脑配置比较好,不然带起来这其中的服务太重了。
2. Elasticsearch:开关键词通道时再装
2.1用脚本启动带IK的实例
仓库已经提供了启动脚本。在项目根目录执行:
sh resources/docker/elasticsearch-8.17.sh
脚本会启动Elasticsearch 8.17.0,映射宿主机的9200端口,并安装同版本的IK分词插件。数据保存在Docker Volume es_data中,容器重建后仍会保留。
不用关键词检索时保持下面这组默认值:
rag:
  keyword:
    type: none
    es:
      uris: http://127.0.0.1:9200
      index: rag_keyword_store
      analyzer: ik_max_word
      search-analyzer: ik_smart
  search:
    channels:
      keyword:
        enabled: false
要打开时,把rag.keyword.type改为es,再把rag.search.channels.keyword.enabled改为true。这两个开关不是重复配置。前者决定是否创建ES客户端、索引服务和关键词通道,后者决定一次检索是否真的让这条通道参与召回。只改后一个、没改前一个,应用会在启动校验时直接指出后端没有装配。
2.2为什么不把它设成默认依赖
关键词检索擅长型号、错误码、订单编号这类精确词,向量检索擅长语义近似,两者融合通常比单路更稳。但“通常更稳”不等于每个本地开发环境都应该强制安装ES。单纯体验Agent的工具循环时,关键词通道并不是前置条件;多维护一份索引,还会增加文档写入、删除与重建时的同步成本。
Ragent的选择是让ES按配置出现。rag.keyword.type=none时,关键词读写实现都不存在,向量写入链路也不会额外挂一层关键词索引同步。等后面专门讲混合检索时再开启,问题边界更干净。
3. LightRAG:图谱能力是一整套栈
3.1 Docker文件放在哪里
LightRAG的本地编排在resources/docker/graphrag/。这不是单独一个LightRAG容器,而是Neo4j + LightRAG两个进程。图数据放Neo4j,LightRAG的KV、向量和文档状态复用宿主机现有的PostgreSQL。
在项目根目录执行:
cd resources/docker/graphrag
cp .env.example .env
# 编辑 .env,填写 BAILIAN_API_KEY,并核对 PostgreSQL 地址和密码
docker compose -f lightrag-neo4j-stack.compose.yaml up -d
POSTGRES_HOST在模板里是host.docker.internal,因为容器要反向连接宿主机PostgreSQL;EMBEDDING_DIM默认是1536,必须与主应用的rag.default.dimension一致。两个服务都变成healthy后,可以访问http://localhost:9621/health检查LightRAG,访问http://localhost:7474打开Neo4j Browser。
3.2后端开关要分清两层
要接入LightRAG,先让后端装配图谱实现:
rag:
  graph:
    type: lightrag
    lightrag:
      base-url: http://127.0.0.1:9621
      query-mode: hybrid
    embedding-model: qwen-emb-8b
  search:
    channels:
      graph:
        enabled: true
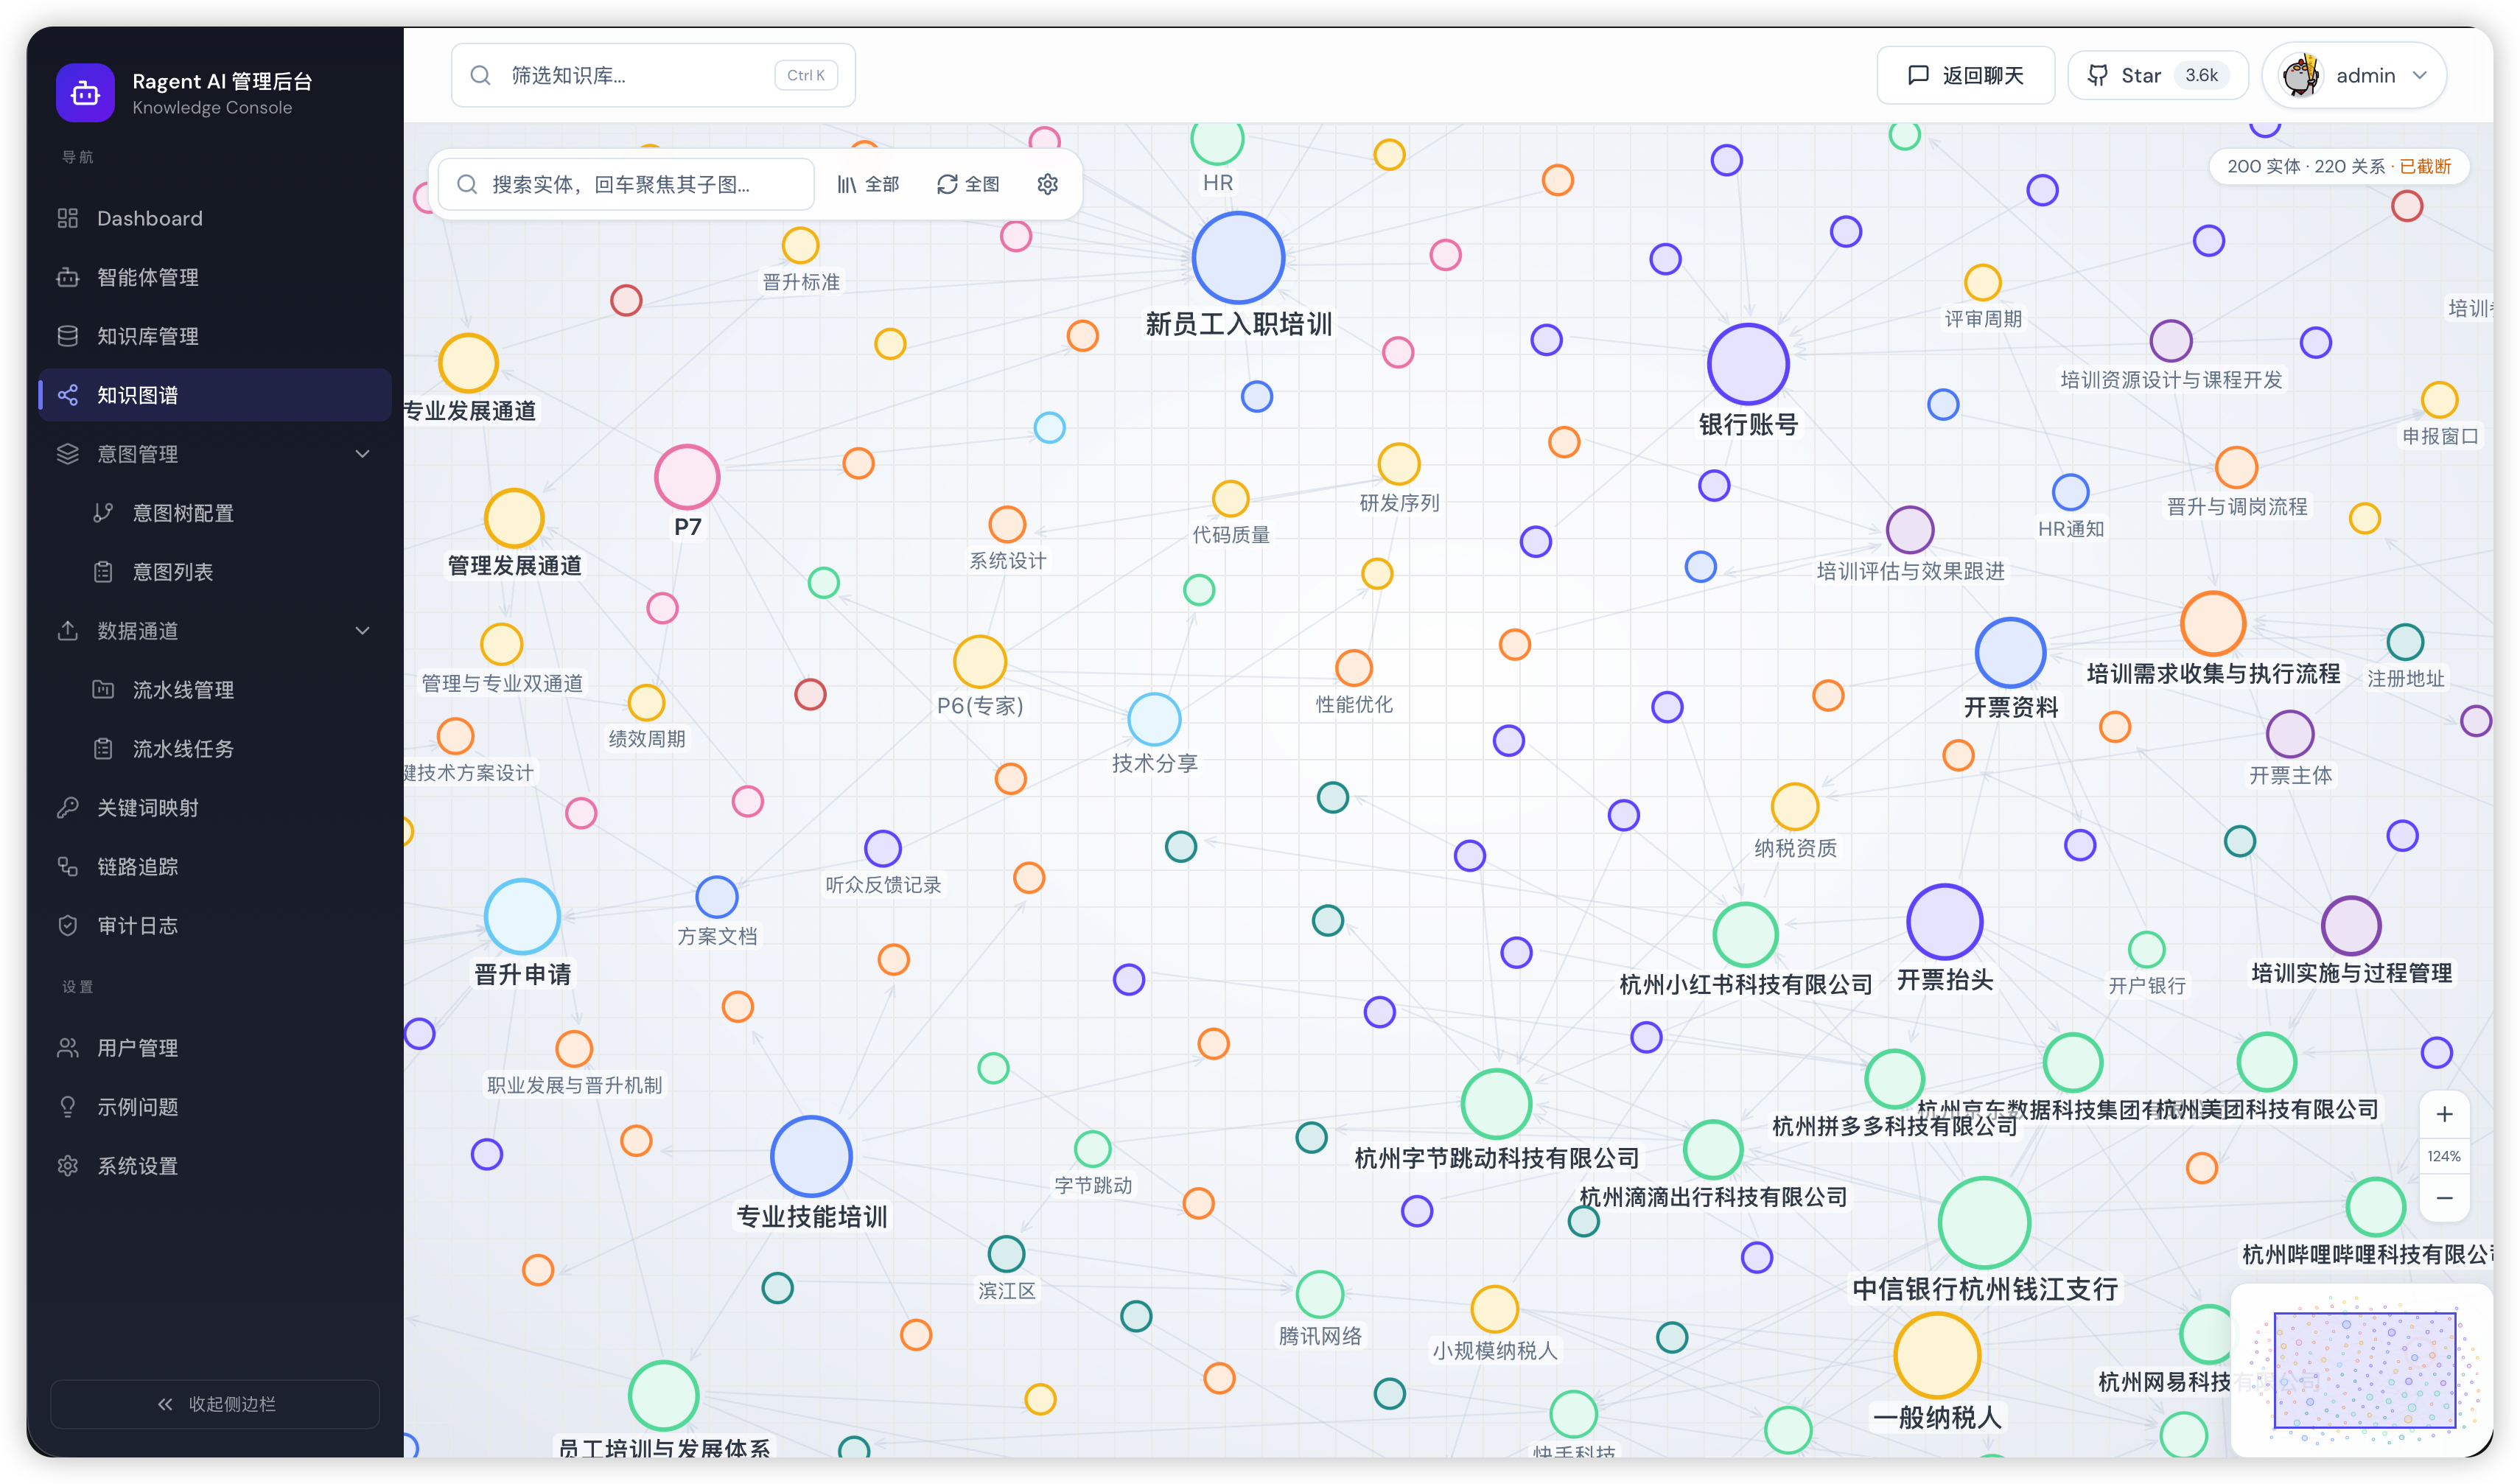
rag.graph.type=lightrag打开后,LightRagClient才会注册,知识文档的向量写入也会同步维护图谱。rag.search.channels.graph.enabled=true决定问答检索时是否把图谱结果并进多通道召回。只想先看后台图谱可视化、暂时不让它参与答案,可以把前一个打开、后一个仍设为false,这是合法组合。
不开图谱时,两处都保持默认关闭。这里不建议为了所谓的“尝鲜”“配置齐全”把type先写成lightrag,因为一旦装配了图谱客户端,后续文档导入就会开始尝试同步图谱。服务没准备好虽然不会阻断主链路,却会留下持续的警告和一份不完整的图数据。
下面这个图是我之前测试数据时跑出来的效果,大家可以参考下:
4. LangFuse:排查链路时再开
4.1本地编排与端口
LangFuse的Compose文件在resources/docker/langfuse/:
cd resources/docker/langfuse
docker compose -f langfuse-stack-v4.compose.yaml up -d
docker compose -f langfuse-stack-v4.compose.yaml ps
六个容器全部健康后,打开http://localhost:3000,本地默认账号为admin@ragent.dev,密码是admintrace。这套编排只把3000端口发布到宿主机,内部使用的ClickHouse、PostgreSQL、Redis和MinIO都走Docker网络,避免与Ragent自己的5432、6379、9000等端口冲突。
4.2主应用怎么接
Compose已经预置了本地项目和密钥,主应用侧打开追踪即可:
agent:
  trace:
    enabled: true
    capture-content: true
    endpoint: http://localhost:3000/api/public/otel/v1/traces
    public-key: pk-lf-ragent-local
    secret-key: sk-lf-ragent-local
capture-content=true会记录完整提示词、模型输出和工具入参出参。本机排障很方便,放到共享环境前要先确认数据边界;只想看轮次、耗时、Token和状态,把它改成false。不用追踪时只把agent.trace.enabled保持为false,LangFuse整套都可以不启动。