Agent架构:大脑、工具、记忆、规划
上一篇把RAG和Agent的边界划清楚了:Agent比RAG多了一条从观察回到思考的边,能自己决定查什么、查几次、什么时候收手。篇末那段消息序列,也让你看到了循环转三圈的时候上下文长什么样。
但盯着那段序列看,多半会冒出一连串问号:
- 那个负责想的东西到底是谁,它凭什么知道下一步该干啥?
- 工具是怎么挂上去的,模型又怎么知道有哪些工具可用?
- 一路往里塞东西的那条轨迹,它就是所谓的记忆吗?
- 说好的自主规划,到底藏在哪儿?
这一篇不急着进代码,先把镜头拉远,给Agent拍一张全景图,把大脑、工具、记忆、规划这四个部件分别讲清楚。全景图装进脑子里,后面一章章拆解的时候,你才知道自己正站在哪一块拼图上。
四个要素
1. 先用一个比喻立住
Agent像比特严选新来的一个同事。把这个比喻掰开:他要独立接待用户、把事办成,靠的是什么?
- 他得有个脑子会思考。用户这句话什么意思、接下来该先干啥。这就是LLM大脑。
- 他得有手脚能干活。查订单系统、翻物流、发起退款,光想不动手没用。这就是工具。
- 他得记得住。用户上一句说了啥、刚才查订单查出来什么,不能转头就忘。这就是记忆。
- 他得会盘算。一个模糊的诉求进来,先干哪步后干哪步,心里得有个谱。这就是规划。
四样缺一不可。没有大脑只会蛮干,没有工具光说不练,没有记忆转头就忘,没有规划东一榔头西一棒。
Agent四要素全景。中心是一个环形回路,四个部件沿回路顺时针排列:大脑、规划、工具、记忆。箭头依次表示大脑思考、规划确定方向、工具执行动作、执行结果写入记忆、记忆再回喂给大脑。回路外侧引出一条通向用户的输出箭头,标注“目标达成时才走这条”。
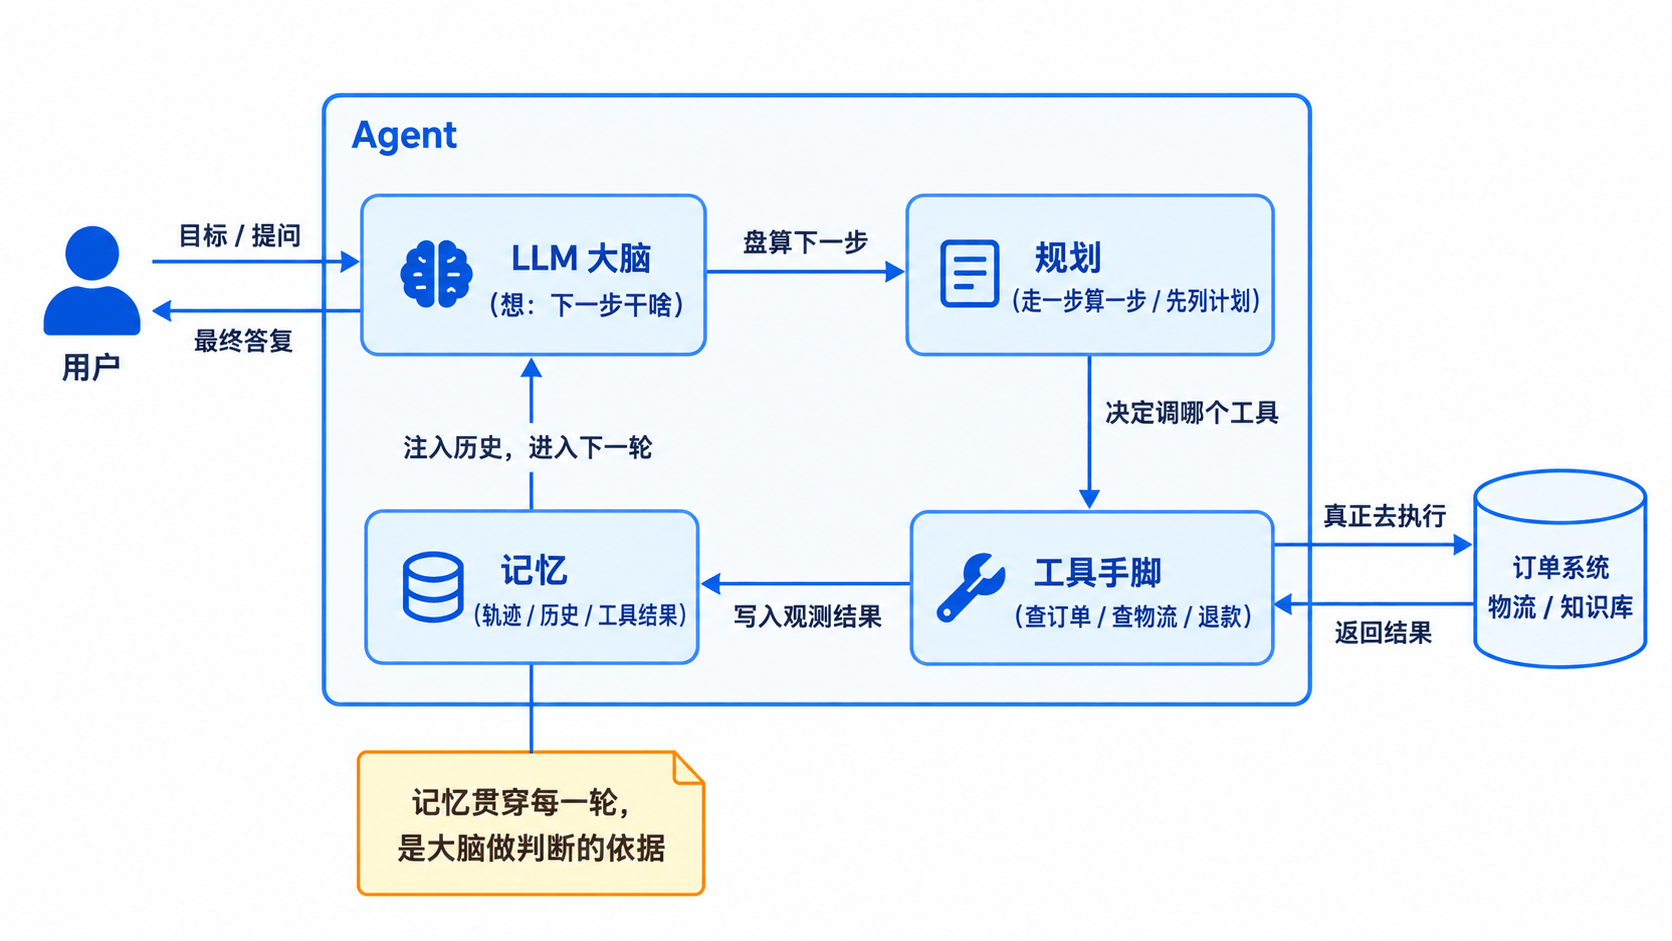
这张图的核心是中间那个回路:大脑想,规划定方向,工具执行,结果写进记忆,记忆再喂回大脑。转一圈又一圈,直到大脑认为目标达成,才把最终答复吐给用户。循环的内部构造,就是这四个部件在协作。
接下来一个一个拆。
2. 大脑:只负责想,不负责干
大脑的职责其实特别单一:基于当前已知的一切,决定下一步干什么。
注意是决定下一步,不是把整件事干完。每转到一轮,大脑被唤醒一次,它看一眼记忆里的轨迹,然后输出一个判断。要么说我还得查个订单,要么说信息够了可以给最终答复了。
这就是它和RAG里那次模型调用最大的不同。RAG里模型被调用一次,任务是根据这些资料组织一段话;Agent里模型被反复调用,每次的任务是根据现在的局面,下一步该怎么走。同样是调LLM,前者在生成内容,后者在做决策。
物理上,大脑就是一次LLM调用,和RAG里用的是同一个接口、同一套鉴权、同一份超时配置。变化的只是喂给它的东西:整条轨迹被拼成一段提示词,逼着模型按先想、再决定动作的格式输出。
| 维度 | 说明 |
|---|---|
| 擅长 | 理解模糊意图、做下一步决策、把工具结果总结成人话 |
| 不擅长 | 精确计算、访问实时数据、记住超长历史(受上下文窗口限制) |
| 工程注意 | 每轮都是一次API调用,循环越长Token和时延越高 |
| 关键认知 | 只负责想和决定,真正干活要靠工具 |
最后这一条得划重点。大脑自己不会查订单、不会发退款。它顶多在输出里说一句我要查订单88231,至于这句话怎么变成一次真实的系统调用,那是工具的事。
3. 工具:Agent唯一能碰到其他系统的地方
承接上面那句。大脑再聪明,它的输出也只是文本。要让那句话产生实际效果,必须有人接住它、去真正调订单系统、再把结果拿回来。这个接住并执行的部件,就是工具。
在比特严选里,典型的工具是这么几个:
- 查订单状态。输入订单号,返回下单时间、商品、当前状态。
- 查物流轨迹。输入运单号,返回最新位置。
- 发起退款或换货。输入订单号和原因,触发售后流程。
- 检索知识库。输入问题,返回相关的保修、退货政策。RAG降级成工具这件事,就发生在这里。
每个工具本质上就是一个方法:明确的入参、明确的出参,干一件确定的事。大脑负责决定调哪个、传什么参,工具负责按指令执行。
这里有个容易被跳过的问题:模型怎么知道有哪些工具可用、每个工具要传什么参数。答案是靠一份工具描述,随每轮请求一起发给模型。业界这份描述基本都长成JSON Schema的样子:
{
  "name": "queryOrder",
  "description": "根据订单号查询订单详情,返回商品名称、下单时间、签收时间、当前状态、运单号",
  "parameters": {
    "type": "object",
    "properties": {
      "orderId": { "type": "string", "description": "订单号,纯数字,如 88231" }
    },
    "required": ["orderId"]
  }
}
这份东西不是给人看的,是给模型看的。description那两行写得越准,大脑越不容易调错工具、传错参数。工具选错这件事,在真实项目里的锅有相当一部分要算在描述头上,而不是算在模型头上。
| 维度 | 说明 |
|---|---|
| 价值 | 让Agent突破纯文本,能查实时数据、能触发真实操作 |
| 复用 | RAG链路、Function Call、MCP(Model Context Protocol,模型上下文协议)都能直接封成工具 |
| 风险 | 退款、改单这类有副作用的工具,调错了是真出事,要加确认与权限(后面章节会说明) |
| 工程注意 | 工具描述写得越清楚,大脑越不容易调错 |
4. 记忆:循环能推进的前提
为什么循环必须要有记忆?
因为大脑每一轮都是一次独立的LLM调用,模型本身是无状态的,它不会自动记得上一轮想了啥、查到了啥。如果每轮都只把用户最初那句话喂给它,它会永远在原地打转,第二轮还会重复第一轮的动作。
记忆就是用来打破这个困境的。它把走过的每一步都记下来,包括大脑的每一次思考、每一次工具调用的结果,下一轮再把整条轨迹喂回给大脑。这样大脑才知道订单我已经查过了、是上周三下的单、那下一步该算保修期了。
所以记忆不是可有可无的组件,它是循环能不断推进而不原地踏步的前提。
循环里那条不断追加的消息列表,就是最原始的记忆形态。它已经抓住了记忆的内核,把轨迹累积下来,再注入到下一轮的提示词里。
但这个内核有个一眼能看穿的问题:轨迹越积越长,迟早撑爆模型的上下文窗口,Token成本也跟着飙。所以真实项目里的记忆模块不会这么裸奔,它要区分短期和长期,要在轨迹过长时做裁剪和压缩。这些是上下文与记忆那一章整章的内容。
| 类型 | 存什么 | 生命周期 | 比特严选里的例子 |
|---|---|---|---|
| 短期记忆 | 当前任务的轨迹、工具结果 | 一次会话内有效 | 这通会话里查到的订单号、诊断走到第几步 |
| 长期记忆 | 跨会话的用户偏好、历史事实 | 长期持久化 | 这个用户家里已有一台HomePod、去年买过iPhone 17 |
短期记忆是循环转起来的刚需,长期记忆则让Agent越用越懂你。两者在Ragent里都做了,但难度和踩的坑完全不是一个量级。