RAG如何成为Agent的工具
上一篇,我们把一段人设从数据库一路送进了模型,也顺手留下了一个名字:search_knowledge。
它看起来只是工具清单里再普通不过的一项,但往后再走一步就会发现:这个Tool背后,挂着的其实是Ragent1.0已经稳定运行很久的一整套RAG管线。
这件事很容易被概括成一句话:给原来的RAG包一层Tool接口。
这么说不能算错,但也几乎绕开了真正的问题。
真正麻烦的,从来不是Tool接口怎么定义、参数怎么传,而是RAG在整个系统里的角色变了。
以前,RAG本身就是一条完整的问答链路:它接收用户问题,结合历史上下文完成检索和生成,组织最终答案,再直接把结果返回给用户。检索、意图识别、引用处理、异常兜底,甚至部分上下文管理,都闭合在这条链路内部。
而到了Ragent2.0,情况完全不同。
RAG不再直接面对用户,而是退到主Agent身后,变成它可以调用的一项能力。主Agent判断这个问题需要查知识库,再把任务交给search_knowledge;RAG完成检索后,也不再直接生成最终回复,而是把结果交还给主Agent,由另一个模型继续推理、整合,最终决定应该怎样回答用户。
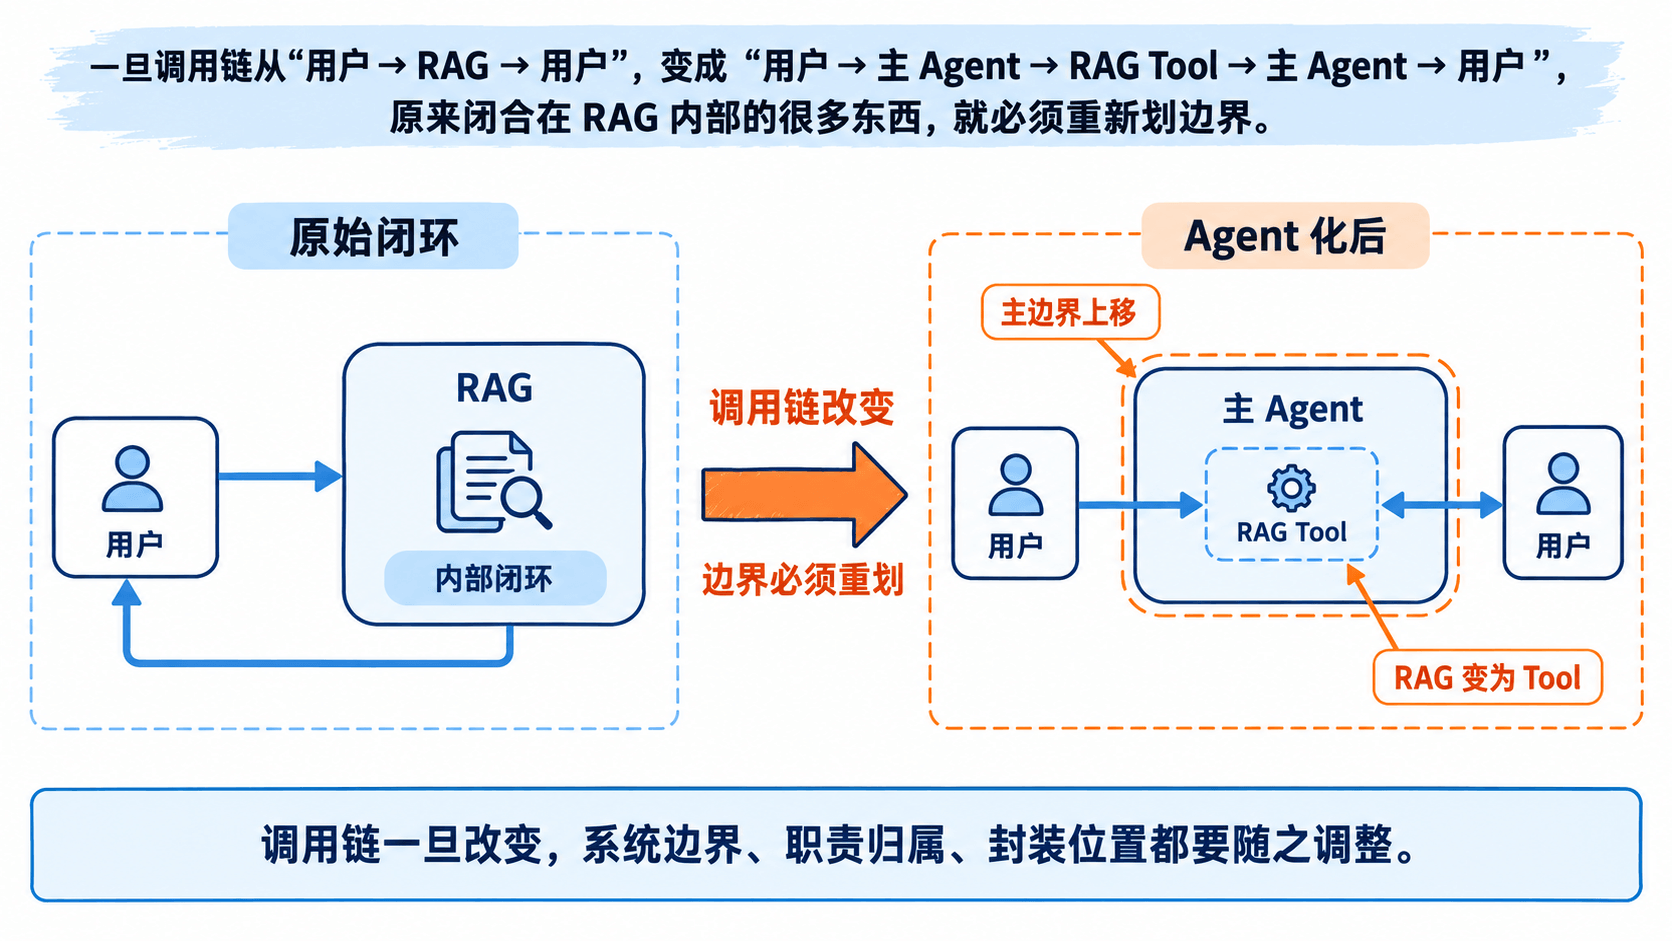
然后引出以下问题:
- 历史消息到底由Agent还是RAG维护?
- 用户问题需不需要再次改写?
- 意图识别应该放在Agent侧,还是继续留在RAG里?
- 知识库引用返回什么粒度?
- 检索失败、模型失败和业务异常,又应该以什么形式交还给主Agent?
这些问题,才是把RAG从一条独立问答链路,改造成Agent Tool时真正需要解决的事情。
RAG没被删,变成了可选工具
1. Agent如何处理用户问题?
用户先问:
AirPods Pro 3拆封后还能退吗?
这是一个典型的政策问题。答案就在退换货资料里,查知识库最合适。
紧接着,他又问:
那我上周买的那副呢?
看起来只是顺着上一句话追问,但问题已经变了。
这一次,光知道“拆封后能不能退”还不够。系统还得先确认:用户上周买的是哪一笔订单、什么时候签收、当前是什么状态,再结合这些信息判断是否满足退换条件。
也就是说,第一句话缺的是规则,第二句话缺的是用户自己的实时订单数据。
问题也正出在这里。
RAG能查到退换货政策,却不知道“上周买的那副”究竟是哪一笔订单、什么时候签收。等主Agent真正开始处理这句话时,还是得再调用query_order查询业务数据。
于是,一次请求里实际上同时存在两套决策逻辑。
一套来自v1.0的固定管线:不管用户问什么,先查一次知识库。
另一套来自v2.0主Agent:根据当前问题、历史上下文和已经拿到的结果,决定下一步应该调用什么工具。
有时候RAG确实是第一步;有时候这一轮根本不需要RAG;还有一些场景,正确顺序应该是先拿到业务数据,再根据结果决定要不要补查知识库。
比如刚才第二句话,更合理的路径其实是:
用户问题 → query_order → 必要时search_knowledge → 回答
而不是:
用户问题 → 固定RAG → query_order → 回答
Ragent2.0调整的,就是这一层关系。
检索不再是每轮请求都必须经过的一站,而是和query_order等业务能力一样,变成主Agent可以按需调用的工具。
主Agent先看当前问题和完整对话,再决定下一步:
- 纯政策问题,调用
search_knowledge。 - 问到自己的订单,先调用
query_order。 - 查完订单后还需要核对退换规则,再调用
search_knowledge。 - 如果已有上下文已经足够回答,就不需要启动RAG。
所以,RAG并没有被删除,原来的能力也没有被推翻。问题改写、意图识别、多通道召回、重排、答案合成,这些能力仍然留在RAG内部。
真正变化的是它在整个系统里的位置。
以前,RAG位于整条请求链路上游。系统决定这一轮必须经过RAG,模型只能继续处理RAG给出的结果。
现在,主Agent才是这一轮请求的调度者。它先理解用户在问什么,再决定要不要调用search_knowledge,以及什么时候调用。
所以,这次变化可以压缩成一句话:RAG从每轮必经的固定管线,变成了由主Agent按需调用的知识工具。
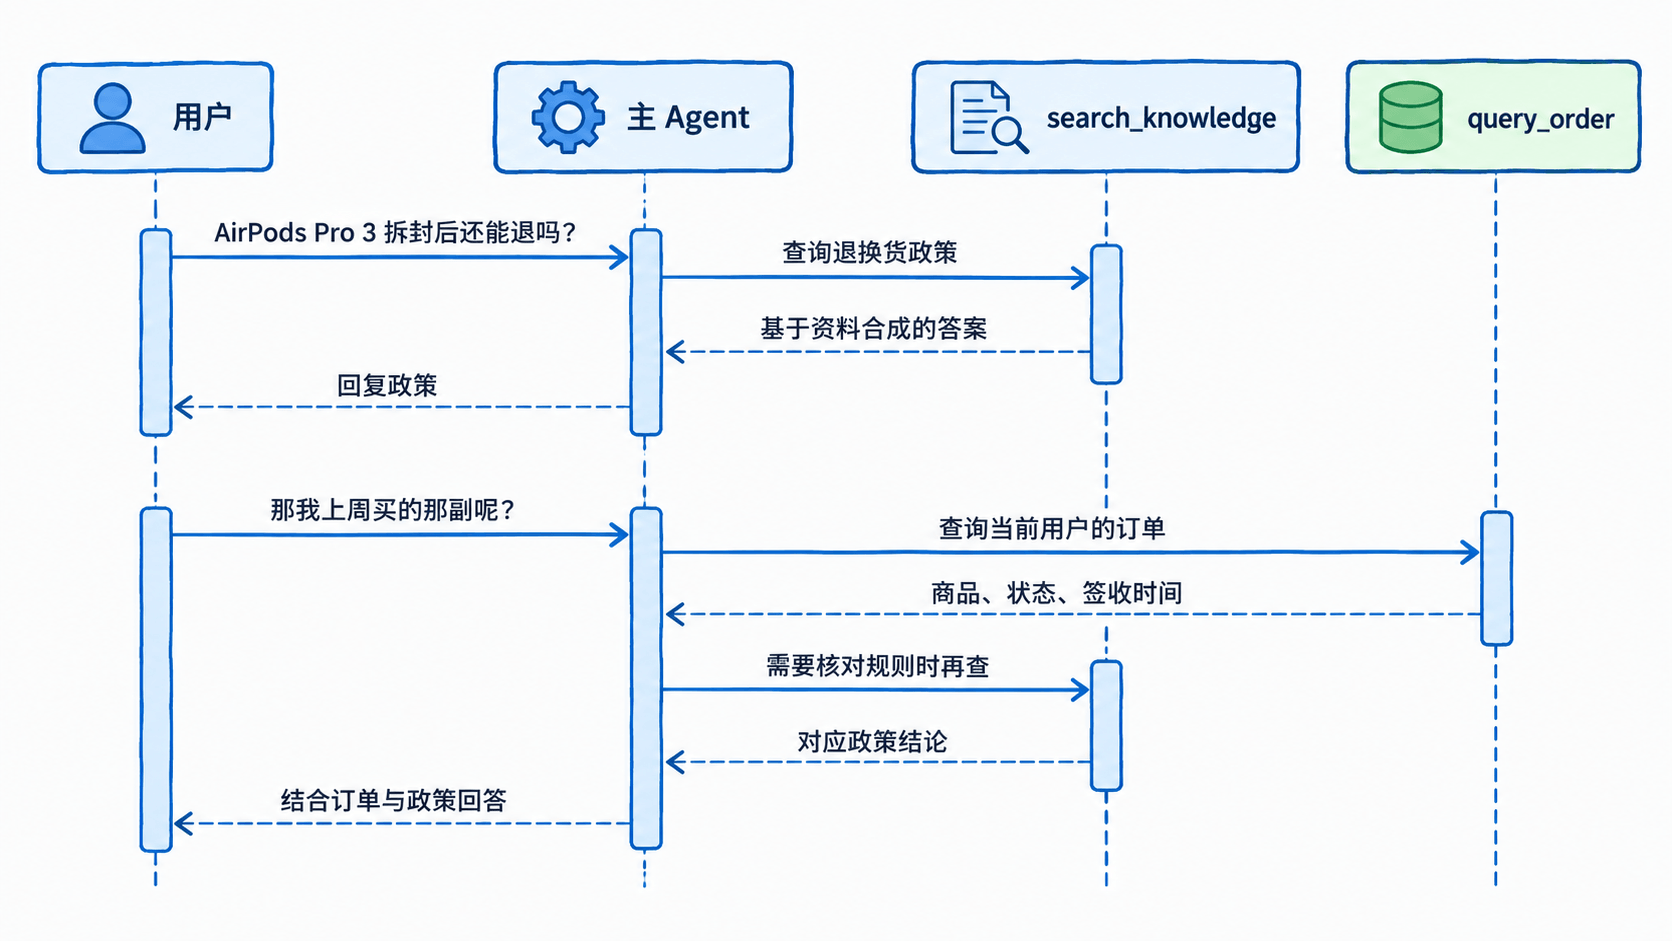
这就是RAG变成工具后最直接的变化:不是能力少了,而是谁有权决定它什么时候运行。
2. Agent看不到实现,只看得到工具契约
主Agent决定要不要调用工具时,看不到KnowledgeSearchFacade里面有多少检索通道,也不知道重排、证据过滤这些逻辑具体怎么实现。
模型真正能看到的,只有工具名、工具描述和参数Schema。
所以KnowledgeSearchTool对外暴露的契约很简单:固定的工具名、一个完整问题,以及对应的工具描述。
@Override
public String getName() {
    return TOOL_NAME;
}

@Override
public String getDescription() {
    return description;
}

@Override
public Map<String, Object> getParameters() {
    return Map.of(
            "type", "object",
            "properties", Map.of(
                    QUERY_PARAM, Map.of(
                            "type", "string",
                            "description", QUERY_DESCRIPTION)),
            "required", List.of(QUERY_PARAM),
            "additionalProperties", false);
}

@Override
public boolean isReadOnly() {
    return true;
}
这里没有把query继续拆成知识库ID、TopK、召回通道、是否重排之类的参数。
不是这些配置不重要,而是它们不应该由主Agent决定。
模型并不知道当前有哪些知识库,也不了解每条检索通道是怎么配置的。如果把这些参数暴露出去,最后很可能只是让模型去猜。
因此,检索范围、召回策略和重排逻辑继续留在RAG内部。主Agent只需要做一件事:把需要查询的问题完整地交给search_knowledge。
相比工具名,工具描述其实更重要。
search_knowledge这个名字只能告诉模型这是一个知识检索工具,但它并不能说明:什么情况下应该调用、它返回什么结果、哪些问题不应该调用。这些信息都放在KNOWLEDGE_TOOL_DESCRIPTION里。
上一篇已经讲过提示词槽位的加载和回落逻辑。每次取Agent实例时,所有槽位先一次读成一份快照,工具目录从这份快照里取描述,取到空值直接抛异常,不会带着空描述把工具挂上去:
private String resolveKnowledgeToolDescription(Map<String, String> prompts) {
    String description = prompts.get(AgentPromptSlot.KNOWLEDGE_TOOL_DESCRIPTION.name());

    if (StrUtil.isBlank(description)) {
        throw new IllegalStateException(
                "KNOWLEDGE_TOOL_DESCRIPTION 提示词不允许为空");
    }

    return description;
}
三条路,最后选了最薄的那一层
1. 推倒重来,没有解决新问题
加Agent之后,一个直觉方案是重写检索:重新做查询改写、召回、重排和答案生成。
但Agent带来的变化是调度权变了,不是原来的RAG能力失效了。
Ragent1.0里的作用域、融合、重排、证据格式和提示词选择都已经跑通。重新实现一遍,不但没有新增能力,还要重新做质量回归。
所以这条路很快被放弃:旧RAG继续保留,只解决怎么让Agent调它这个新问题。
2. 迁进框架,反而多了一层适配
第二条路是接AgentScope自带的RAG抽象。
问题在于,框架提供的是一套通用检索模型,而Ragent已经有自己的检索语义。
例如SubQuestionIntent不只记录正文和分数,还保留子问题命中了哪些意图、哪些意图最终拿到了有效证据。RAGPromptService又会根据这些结果选择专用模板,无法明确归属时才回落到通用的KB_ANSWER。
要迁进框架,就得把这些信息塞进通用对象,再在后面重新还原。最终不仅没省掉多少代码,反而多了一层中间模型。
更关键的是,AgentScope 2.0.2已经把这组RAG入口标记为待删除,检索转向应用层集成。
所以没必要为了接入Agent,再把一套已经稳定的RAG强行改造成框架的形状。