上下文放不下了,先裁剪哪些消息
聊到第八轮,上下文长到了44,925字符
接着上一篇那位用户往下走。这次我们在Ragent上把这段经历真跑了一遍:同一个会话,连问八轮。第一轮还是序章那句话:
我上周买的AirPods Pro左耳突然没声音了,放回充电盒也没用,你帮我看看是不是坏了,要是修不好我想退。先帮我排查,暂时不要提交售后、退货或下单。
Agent加载了故障排查手册,查了订单和知识库,给出第一步:两只耳机放回盒里,合盖等一会儿。第二、三轮用户回来说还是没声,清理过也没用,Agent没再查资料,接着往下排查。第四轮用户改了主意:
那我换AirPods Max吧,你帮我看看值不值。
之后几轮,Agent查了AirPods Max的规格,比了两款耳机,翻订单看还能不能退,查了送修要准备什么,最后做了一份总结。
每轮答完,我们数一下模型读的那份会话记录有多长:
| 轮次 | 这一轮在干什么 | 查资料了吗 | 记录总长(字符) | 这轮新增 |
|---|---|---|---|---|
| 1 | 开始排查 | 查了 | 6,114 | 6,114 |
| 2 | 反馈合盖后仍无声 | 没查 | 6,656 | 542 |
| 3 | 反馈清理后仍无声 | 没查 | 7,177 | 521 |
| 4 | 改问AirPods Max | 查了 | 16,567 | 9,390 |
| 5 | 对比两款耳机 | 查了 | 28,269 | 11,702 |
| 6 | 查订单,看能不能退 | 查了 | 37,666 | 9,397 |
| 7 | 查送修要准备什么 | 查了 | 41,744 | 4,078 |
| 8 | 总结前面的结论 | 没查 | 44,925 | 3,181 |
规律一眼就能看出来:没查资料的轮次只涨几百字,查了资料的轮次一涨就是几千上万。涨上去的不只是查回来的结果,还有模型读完结果写下的思考和回答。到第八轮,这44,925字符大致三等分:用户和助手的对话、工具返回的结果、模型的思考过程,各占三分之一左右。
这些内容每调用一次模型就要重新读一遍。同样是一次模型调用,第一轮开头模型读了4,253个token,第八轮读了29,233个。token是模型计费的单位,里面还算上了系统提示词、工具说明这些每次都要带的内容,所以它和上面的字符数不能直接换算。
Ragent给这份记录定的预算是100,000字符(仅是示例,需要结合实际情况调整),配置项agent.memory.context-window-chars。这是工程上定的上限,不是模型窗口的大小。记录过了50,000开始执行裁剪,过了80,000开始摘要。八轮才到44,925,两条线都没碰到,所以这八轮里什么都没省。
但再聊下去,线迟早会碰到。到那时要先回答的问题是:这四万多字符里,哪些可以先不带?几轮前查回来的排查资料、刚查到的订单、已经提交成功的售后申请结果,待遇显然不该一样。
1. 先问清楚“不带”的是哪份记录
同一段对话,Ragent存了两份,分在两张表里。
用户在页面上看到的那份存在t_agent_message。一轮对话写两行:用户说的话一行,助手的回答一行,这个会话聊了八轮,表里就是16行。助手那一行还有个blocks字段,按时间顺序记着这一轮的思考、调了哪些工具、工具返回了什么,页面刷新之后靠它把那条时间线回放出来。
模型读的那份存在t_agent_state。一个会话只有一行,state_key固定是agent_state,整份工作状态放在payload这个JSONB字段里,由AgentScope框架自己编码。其中payload.context是一个消息数组:每轮开始时框架把它读出来,这一轮里模型每调用一次都读整份数组,一轮跑完再连同新产生的消息整行写回。开头那张表数的就是这个数组,裁剪改的也是它。
两份记录连形状都不一样。八轮聊完,页面那边是16行,context里是35条消息,光第一轮就占了9条:
| 序号 | 角色 | 内容 |
|---|---|---|
| 1 | USER | 首轮提问:“我上周买的AirPods Pro左耳突然没声音了……” |
| 2 | ASSISTANT | 思考 + 两个工具调用:load_skill(fault_diagnosis)、query_order(limit: 5) |
| 3 | TOOL | load_skill的结果 |
| 4 | TOOL | query_order的结果 |
| 5 | ASSISTANT | 思考 + query_order(limit: 20) |
| 6 | TOOL | 订单结果 |
| 7 | ASSISTANT | 思考 + search_knowledge |
| 8 | TOOL | 检索结果 |
| 9 | ASSISTANT | 思考 + 给用户的回答 |
| 10 | USER | 第二轮提问 |
USER、ASSISTANT、TOOL是AgentScope的消息角色。纯聊天里一轮就是一问一答两条,这里用户只说了一句,模型却被调用了四次:前三次,模型都是先写一段思考过程,说清楚下一步要查什么,再发起工具调用(第2、5、7条),工具的结果再作为TOOL消息写回数组(第3、4、6、8条),第四次才回答用户(第9条)。这四条TOOL消息不是谁说的话,却占了第一轮6,114字符里的一半多。
这些消息在库里存成什么样,直接看数据。下面是第八轮答完时payload的真实内容,只留前两轮,每个块的正文只留开头:
// t_agent_state.payload,第八轮答完时的快照
{
  "context": [
    // 第 1 条:用户提问
    {"role": "USER", "content": [{"type": "text", "text": "我上周买的 AirPods Pro 左耳突然没声音了……"}]},
    // 第 2 条:一段思考 + 两个工具调用
    {"role": "ASSISTANT", "content": [
      {"type": "thinking", "thinking": "用户要排查 AirPods Pro 左耳没声音。这属于故障诊断场景……"},
      {"type": "tool_use", "id": "call_00_qGRj…", "name": "load_skill", "input": {"skill_code": "fault_diagnosis"}},
      {"type": "tool_use", "id": "call_01_zDpK…", "name": "query_order", "input": {"limit": 5}}
    ]},
    // 第 3 条:load_skill 的结果,id 和第 2 条里第一个调用相同
    {"role": "TOOL", "content": [{"type": "tool_result", "id": "call_00_qGRj…", "name": "load_skill", "state": "success",
      "output": [{"type": "text", "text": "已加载技能「故障诊断」。以下是这件事的办理手册……"}]}]},
    // 省略:第 4~6 条,query_order 的结果,以及又查了一次订单
    // 第 7、8 条:查知识库,一个调用配一个结果
    {"role": "ASSISTANT", "content": [
      {"type": "thinking", "thinking": "找到 AirPods Pro 3 订单 88232,下单 2026-08-25,已签收……"},
      {"type": "tool_use", "id": "call_00_hksq…", "name": "search_knowledge", "input": {"query": "AirPods Pro 3 单侧(左耳)耳机没有声音……"}}
    ]},
    {"role": "TOOL", "content": [{"type": "tool_result", "id": "call_00_hksq…", "name": "search_knowledge", "state": "success",
      "output": [{"type": "text", "text": "针对 AirPods Pro 3 左耳没有声音的问题,可按以下顺序排查……"}]}]},
    // 第 9 条:一段思考 + 给用户的回答
    {"role": "ASSISTANT", "content": [
      {"type": "thinking", "thinking": "按手册,一次只让用户做一步……"},
      {"type": "text", "text": "先跟你确认一下设备:你这台是 **AirPods Pro 3**……"}
    ]},
    // 第 10、11 条:第二轮没调工具,只有一问一答
    {"role": "USER", "content": [{"type": "text", "text": "两只一起放回去、合盖等了30秒再拿出来……"}]},
    {"role": "ASSISTANT", "content": [
      {"type": "thinking", "thinking": "第1步确认失败。进行第2步……"},
      {"type": "text", "text": "收到:两只一起放回、合盖 30 秒,左耳仍**完全没声音**……"}
    ]}
    // 省略:第 12~35 条,第三轮到第八轮
  ]
  // 省略:session_id、summary 等框架自己的状态,以及消息和块上的 id、usage、timestamp、metadata 等字段
}
对着上面那张表看,这段数据里值得留意的地方:
- 每条消息就是一个
role加一个content数组,数组里每一项带一个type。这里出现了text、thinking、tool_use、tool_result四种,后面按它们拆账如何裁剪。 - 调用和结果不在同一条消息里,靠
id对上:第2条的call_00_qGRj…对第3条,第7条的call_00_hksq…对第8条。下面讲丢消息为什么会出事,出事的就是这对id。 - 第二轮只有第10、11两条,一问一答,没有工具调用和结果。开篇那张轮次表里第二轮只涨了542字符,原因就在这。
同样这一轮,用户在页面上看到的是这样:
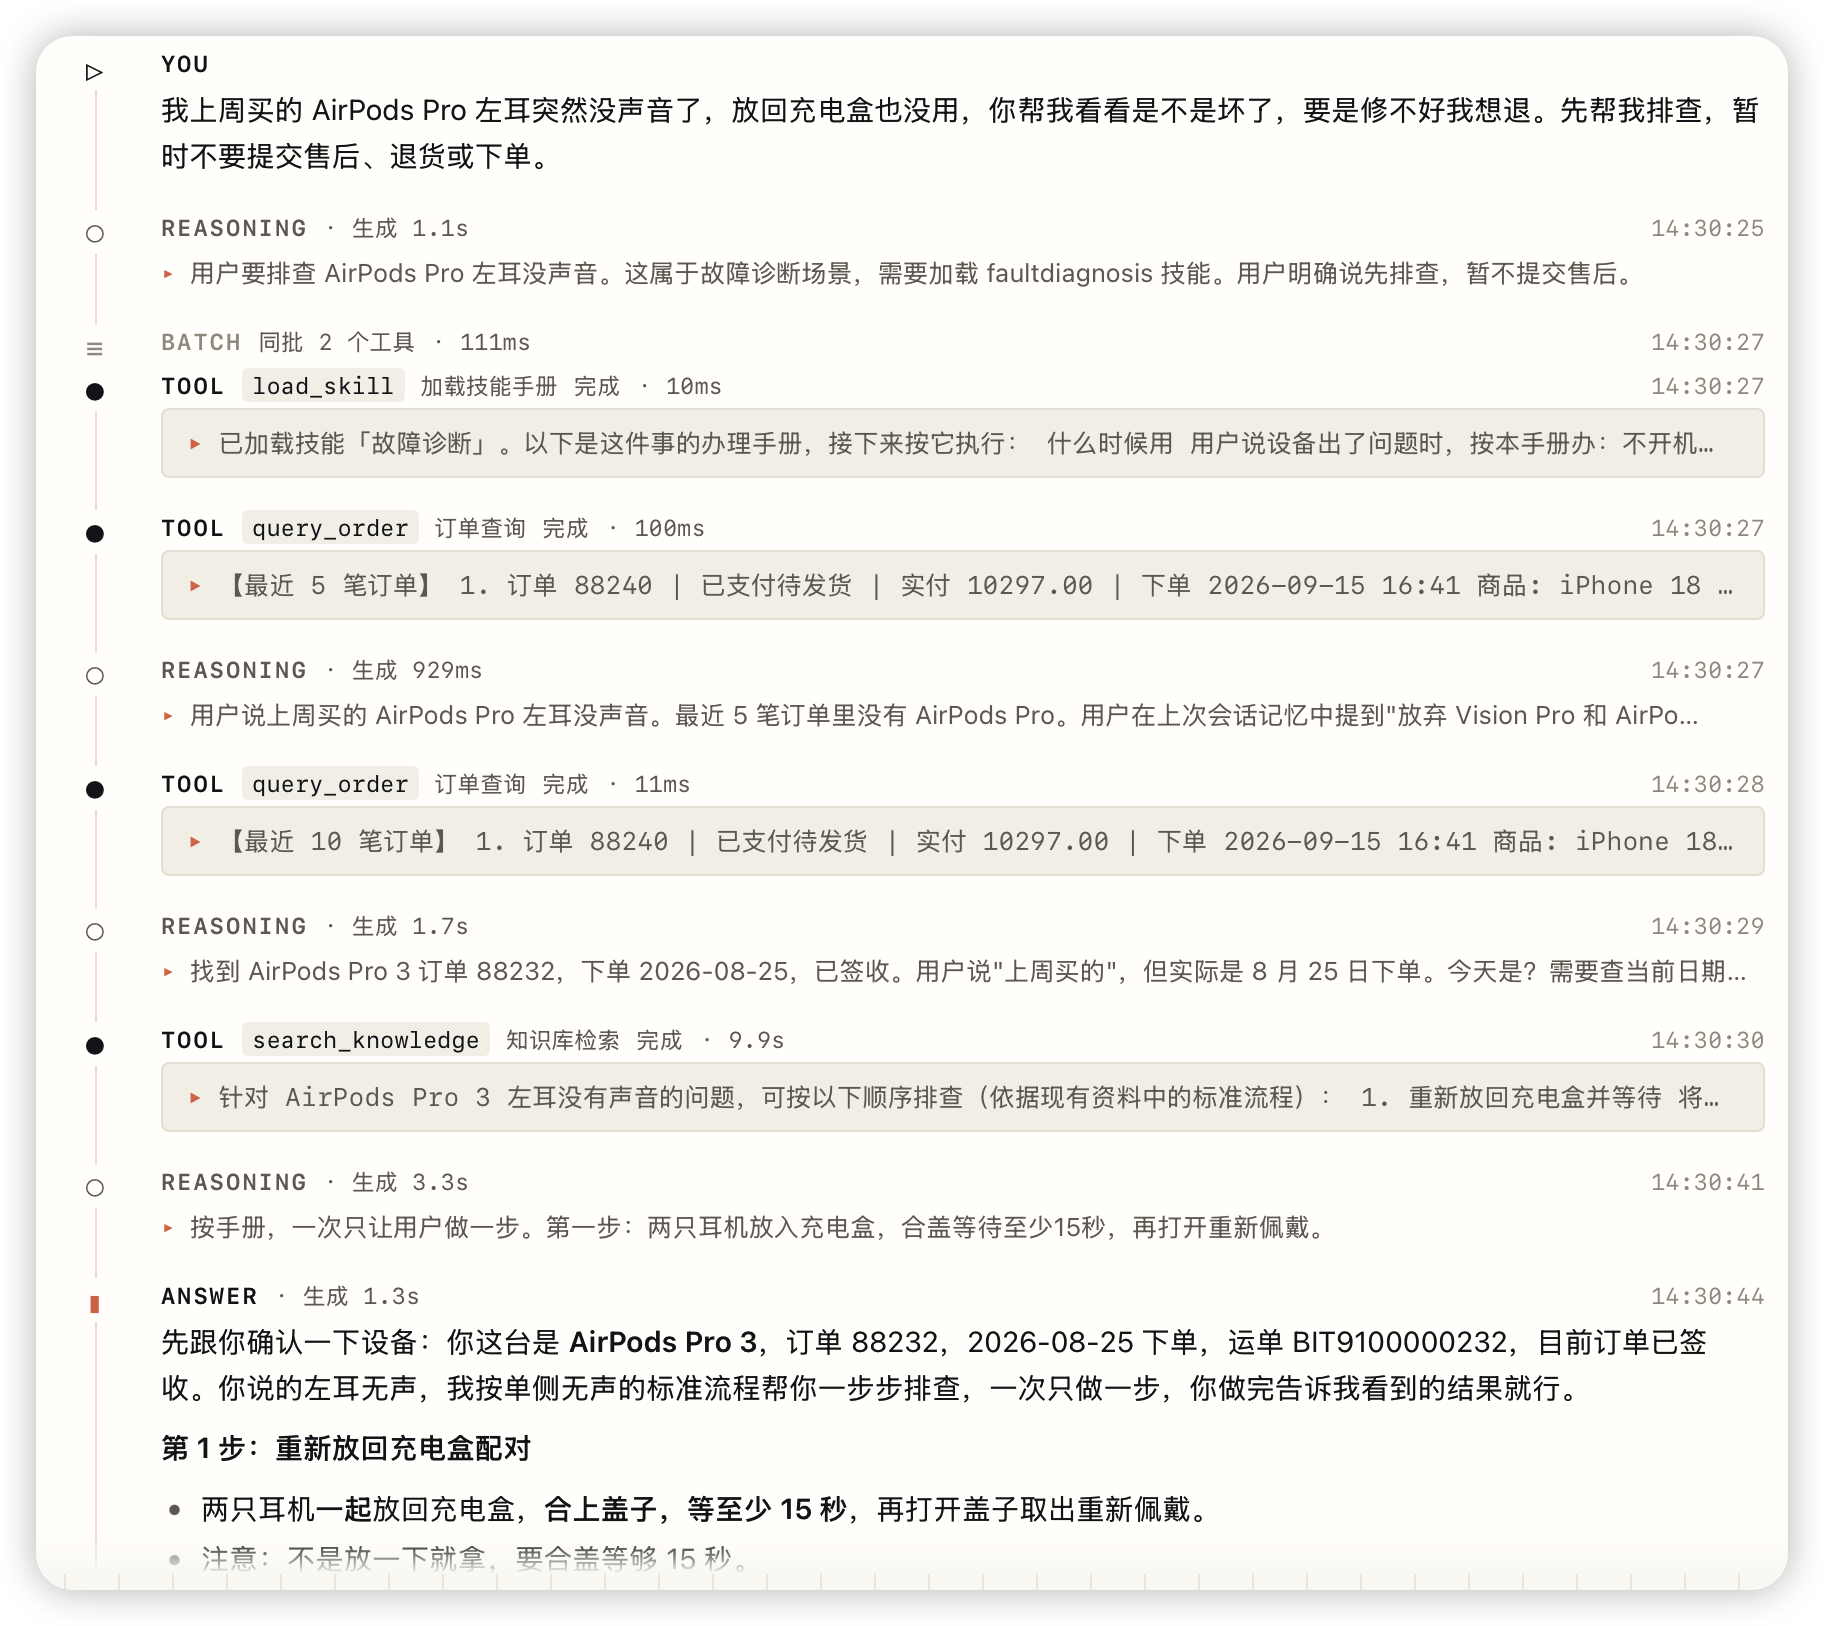
t_agent_message那份的blocks里虽然也存着工具结果,但它只给页面回放用,模型不读,裁剪也不碰。所以裁剪出了错,用户看不到消息消失,只会觉得模型答得变差,而且不会有任何报错。
2. 丢最老的几条,丢到第二条就出问题
最简单的办法是从最老的消息开始丢,丢到长度够了为止。纯聊天这样够用,ChatGPT早期的滑动窗口就是这么做的。
放进Agent就不行了,拿上面第一轮那几条来说。丢掉第1条,“修不好我想退”这个目标就没了。再丢第2条,第3、4条就成了找不到调用的结果。调用(ToolUseBlock)和结果(ToolResultBlock)靠上面JSON里那个id配对,模型接口会检查,配不上的请求直接被挡回来。
那调用和结果一起丢呢?能丢,但不划算。八轮里12个工具调用加起来才604字符,大头全在结果里,有14,851。要省就省结果正文,调用留着,模型至少还知道这件事查过。
所以业界在这个位置上分了岔:
| 做法 | 省掉的东西 | 代价 |
|---|---|---|
| 丢最老的几条 | 消息条数下降,省得最干脆 | 要处理配对关系,且早期的诉求直接没了 |
| 把旧结果正文换成占位 | 只省结果正文,条数不变 | 省得有限,最多只能省掉工具结果那一块 |
| 把早期记录整段换成摘要 | 省得最多 | 有损,且要同步等一次模型调用 |
Ragent后两种都做了,按水位分工:过了预算一半走第二种,过了八成才走第三种。这一篇只讲第二种。
3. 就地替换,不是删除
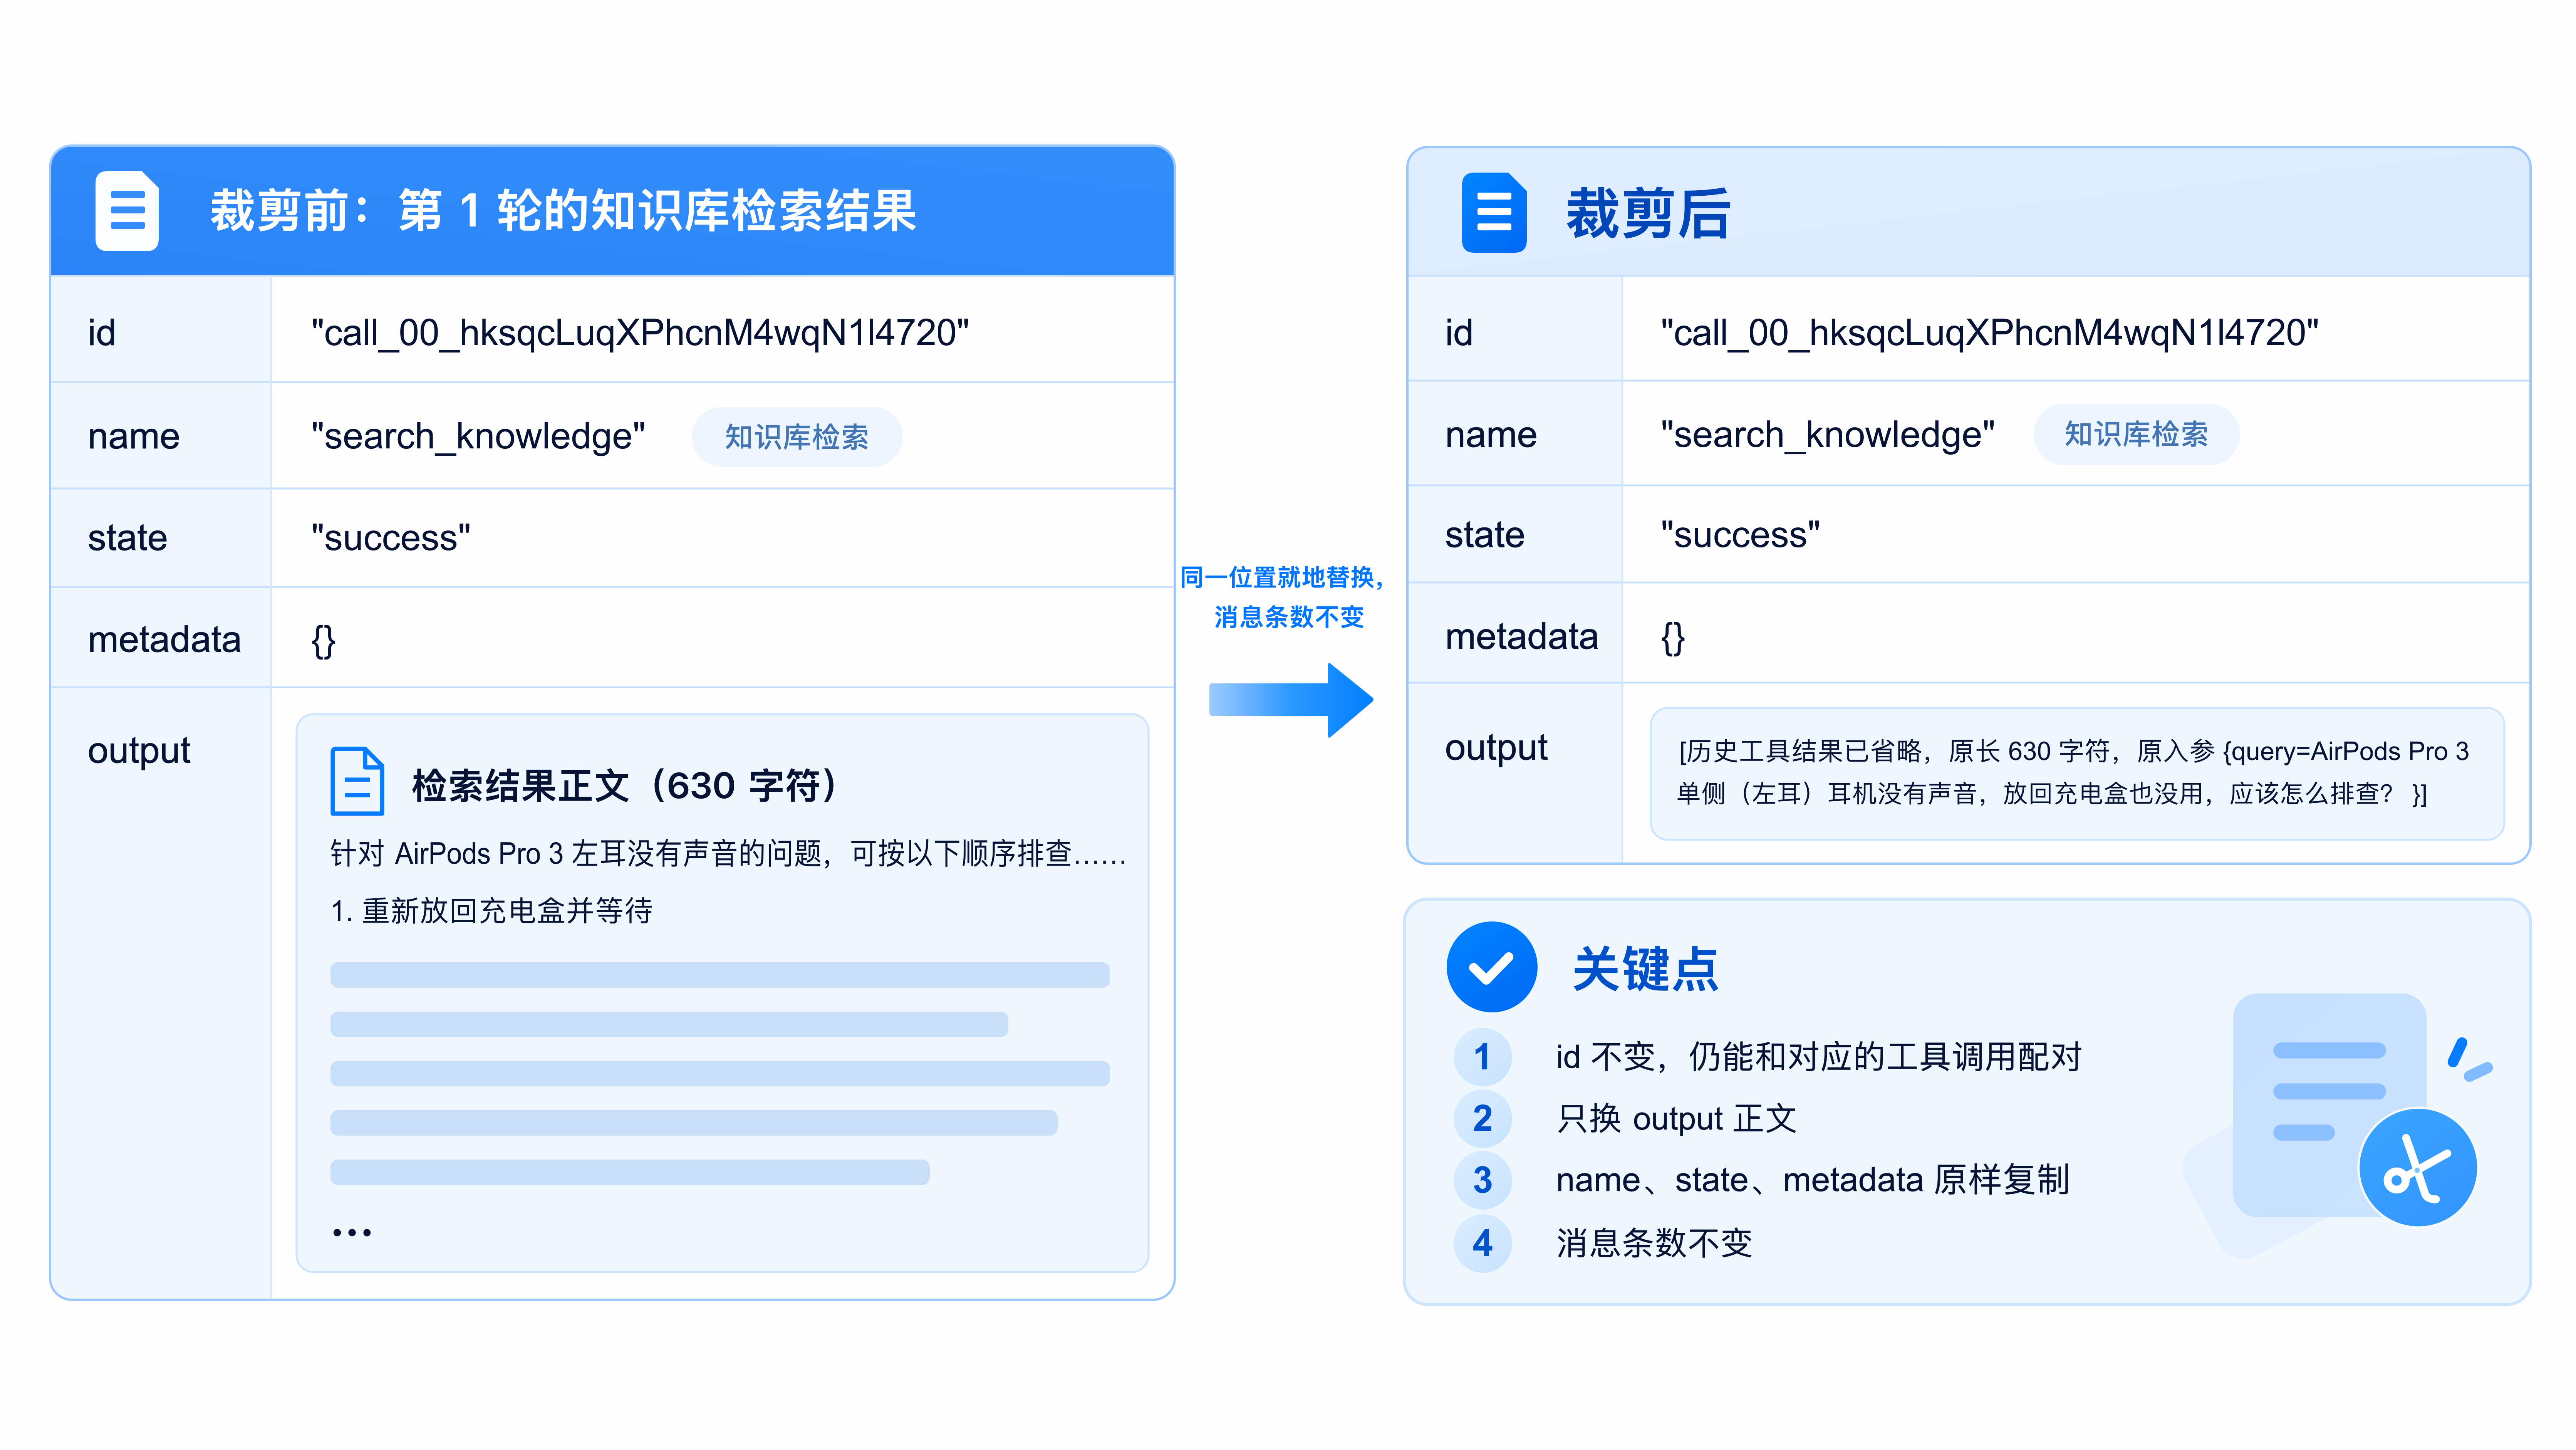
第二种做法落下来是什么样,还拿第一轮那几条看。假设聊到很后面,记录过了裁剪线,第一轮第8条那份知识库检索结果已经落进了可清区(哪些能进可清区,后面几节会讲),裁剪前后是这样:
| 序号 | 角色 | 裁剪前 | 裁剪后 |
|---|---|---|---|
| 7 | ASSISTANT | 思考 + search_knowledge调用,id是call_00_hksq… | 不变 |
| 8 | TOOL | 检索结果正文,630字符 | [历史工具结果已省略,原长 630 字符,原入参 {query=AirPods Pro 3 单侧(左耳)耳机没有声音,放回充电盒也没用,应该怎么排查?}],77字符 |
| 9 | ASSISTANT | 思考 + 给用户的回答 | 不变 |
变的只有第8条的正文,630字符变成77字符,省下553。没变的有三样:
- 第8条还在原来的位置,整份记录还是35条
- 它的id还是
call_00_hksq…,和第7条的调用照样配得上 - 第7条的调用一个字没动,模型还看得到当时查过知识库、查的是什么
这是单独一条的样子。真触发裁剪的时候,符合条件的候选会一批一起换;没有候选就保持原样。